فناوری، میدان تصفیهحساب سیاسی نیست
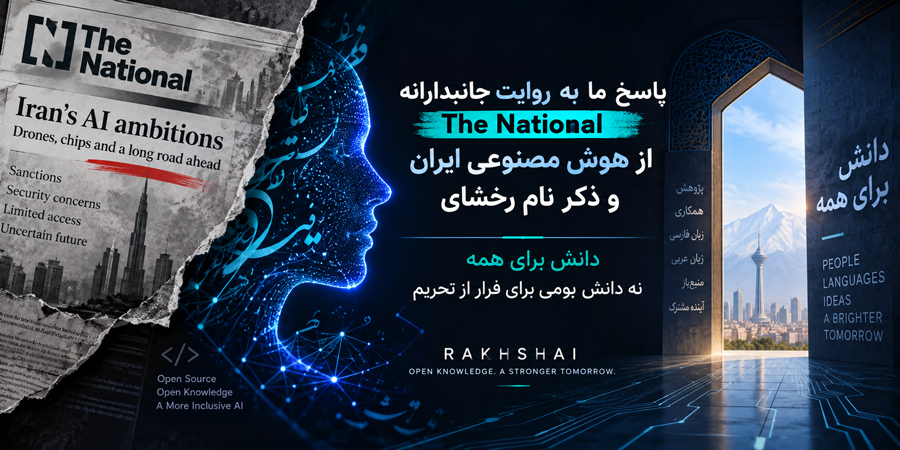
گزارش ۵ دسامبر ۲۰۲۵ رسانه اماراتی The National از رخشای نام برده است؛ اما موضوع پاسخ ما، دفاع از یک نام تجاری نیست. ما بهعنوان یک شرکت ایرانی و بخشی از جامعه فناوری ایران، به شیوه روایت توان علمی کشورمان اعتراض داریم و به هیچ عنوان اینگونه ادبیات را نمی پسندیم. در ابتدا به دلیل ادبیات سطح پایین مقاله و نداشتن دید علمی محور تمایلی به پاسخ نداشتیم اما بعد از درخواست مخاطبان ترجیح می دهیم پاسخی کوتاه به مقاله بدهیم. (The National)
برجستهسازی موضوعات نظامی در عنوان و آغاز گزارش، و سپس ورود به موضوع جرایم سایبری و ادبیات پروندهمحور، از نگاه ما صرفاً انتخاب یک زاویه خبری نیست. گزارش دارای زاویهای است که بهنظر ما تصویر کاملی از اکوسیستم AI ایران ارائه نمیکند نقد فناوری باید از بررسی دستاورد آغاز شود، نه از ساختن فضایی که ملیت سازنده را به موضوع سوءظن تبدیل کند.
نمیتوان هوش مصنوعی را زیر سایه یک دیدگاه سیاسی و نظامی قرار داد . از دید ما هوش مصنوعی باید در خدمت بشریت و انسانیت باشد و تمام تلاش ما صرفا در مسیر استفاده از هوش مصنوعی در خدمت فرهنگ ایرانی است .
مقاله مورد نظر به میزانی جانبدارانه است که ترجیح میدهیم این نکته را هم روشن کنیم که نمیتوان حفاظت از امنیت را برای خود ضرورتی بدیهی دانست، اما تلاش دیگران و کشور های دیگر برای دستیابی به توان دفاعی را بهانهای برای زیر سؤال بردن تمام مسیر توسعه آنان قرار داد. امنیت مردم ایران، کمتر از امنیت مردم هیچ کشور دیگری نیست.
به باور ما، ارزیابی فناوری باید حوزههای مختلف را از یکدیگر تفکیک کند: پژوهش دانشگاهی، زیرساخت محاسباتی، مدلسازی، محصولات تجاری، کاربردهای غیرنظامی و کاربردهای امنیتی و دفاعی هر یک معیارهای متفاوتی دارند.
«هرگز» یک نتیجه علمی نیست
در این گزارش این ادعا نقل شده که ایران «هرگز» همتراز امارات و عربستان نخواهد شد؛ استدلالی که بر تفاوت دسترسی به تجهیزات پیشرفته تکیه دارد. (The National)
“Iran can smuggle small batches of legacy chips, but it will never be in the same league as Saudi Arabia or the UAE … and that gap will only widen.”
پرسش ما ساده است: در کدام حوزه، با کدام معیار و در چه افق زمانی؟
از فاصله امکانات امروز، نمیتوان ناتوانی همیشگی یک ملت را نتیجه گرفت. برای داوری علمی باید کیفیت مدل، معماری، روش آموزش، بهرهوری محاسباتی و عملکرد واقعی را سنجید. فهرست تجهیزات، پاسخ تمام این پرسشها نیست.
اگر نوآوری فقط با صورتحساب خرید پردازنده اندازهگیری میشد، واحد تدارکات و تجهیزات میتوانست جای آزمایشگاه تحقیق و توسعه را بگیرد.
آمار اشتباه در رتبه بندی
این رسانه میگوید ایران در «شاخص آمادگی دولت برای هوش مصنوعی» سال ۲۰۲۴ در رتبهٔ ۹۱ قرار داشته، در حالی که امارات و عربستان سعودی «هر دو در میان پنج کشور نخست» بودهاند. اما رتبهبندی Oxford Insights در سال ۲۰۲۴، امارات را حدود رتبهٔ ۱۳ جهان و عربستان سعودی را رتبهٔ ۲۲ قرار میدهد؛ خلاصهای جدیدتر از Middle East Institute نیز این رتبهبندی را تأیید میکند.
ما به دنبال گسترش فن آوری متن باز هستیم نه فن آوری های محدود بومی!
ما RGN را برای محصور کردن فناوری در مرزهای ایران توسعه ندادهایم؛ هدف ما، گسترش زیرساخت متنبازی است که پژوهشگران بتوانند آن را بررسی کنند، بهبود دهند و برای زبانها و کاربردهای تازه، از جمله عربی، توسعه دهند. ایرانی بودن معماری، بیانگر خاستگاه دانش فنی آن است، نه مرز استفاده از آن. استقلال فناورانه برای ما یعنی توان ساختن و بهاشتراکگذاشتن دانش؛ نه انزوا و نه صرفاً جایگزینسازی خدمات تحریمشده. تقلیل این مسیر به «راهی برای فرار از تحریم»، بیش از آنکه هدف پروژه را توضیح دهد، محدودیت نگاه نویسنده را آشکار میکند: ما درباره مشارکت در ساخت فناوری جهان صحبت میکنیم؛ ظاهراً بعضیها هنوز برای ایران، نقشی فراتر از مصرفکننده تصور نمیکنند.
مدل ایرانی و معماری ایرانی؛ نه صرفاً خرید فناوری
ما از سال ۱۳۹۸ خورشیدی توسعه مدل ایرانی خود را آغاز کردهایم. امروز در آزمایشگاه هوش مصنوعی هامان، مدل ایرانی با معماری گرافمحور طراحی و پیادهسازیشده در ایران توسعه دادهایم؛ معماریای که مدل زبانی را با شبکه عصبی گرافی و سازوکار ترکیب اطلاعات گراف و متن پیوند میدهد. (آزمایشگاه هوش مصنوعی هامان)
وزنهای مدل از مقداردهی اولیه تصادفی آموزش دیدهاند و توکنساز، گراف و مسیر آموزش برای فارسی ساخته شدهاند که میتوان آن را برای زبان عربی نیز گسترش داد . موضوع، یک پوسته فارسی روی محصول آماده خارجی نیست؛ موضوع، ساخت مدل، معماری و زیرساخت آموزش در ایران است. کد و مستندات نیز برای بررسی فنی منتشر شدهاند. (آزمایشگاه هوش مصنوعی هامان)
برای ارزیابی ظرفیت فنی این پروژه، مهم است میان «استفاده از یک مدل موجود برای زبان فارسی» و طراحی یک معماری توسط یک تیم ایرانی تفاوت قائل شویم. Haman Persian Article Graph-LLM صرفاً نسخه فارسیشده یا fine-tune شدهی یک مدل خارجی نیست؛ هسته معماری آن در چارچوب پروژه RGN توسط تیم ایرانی طراحی و پیادهسازی شده است. این معماری یک Transformer علّی دهلایه را با GCN و سازوکار اختصاصی context-gated graph-token fusion ترکیب میکند تا علاوه بر توالی خطی توکنها، ساختار روابط واژگانی موجود در پیکره نیز مستقیماً در فرایند مدلسازی زبان حضور داشته باشد. گراف مورد استفاده شامل 31,995 گره و 68,759 یال است و اطلاعات آن صرفاً بهعنوان یک افزونه بیرونی به مدل متصل نمیشود؛ بلکه از طریق لایههای fusion در سطح نمایش توکنها وارد هسته محاسباتی مدل میشود. نکته اصلی این پروژه در همینجاست: معماری، مسیر اتصال گراف به Transformer، pipeline داده، آموزش و پیادهسازی نهایی بهعنوان یک زنجیره فنی یکپارچه توسط یک تیم ایرانی توسعه یافتهاند، نه اینکه تنها یک مدل آماده خارجی برای داده فارسی تطبیق داده شده باشد.
این تمایز زمانی اهمیت بیشتری پیدا میکند که مدل 124,978,951 پارامتری از وزنهای تصادفی و بدون استفاده از یک LLM پایه خارجی، distillation، embedding ازپیشآموزشدیده یا داده مصنوعی تولیدشده توسط LLM آموزش داده شده است. آموزش طی دو epoch و با یک NVIDIA A100 40GB انجام شده و حدود 396.9 میلیون token exposure را پوشش داده است؛ در مجموعه validation نیز loss برابر 3.4645 و perplexity برابر 31.96 گزارش شده است. بنابراین دستاورد اصلی را نباید صرفاً در اندازه مدل یا یک عدد benchmark خلاصه کرد. خروجی این پروژه نشان میدهد که یک تیم ایرانی توانسته است از سطح مصرف و تنظیم مدلهای موجود عبور کند و وارد لایه طراحی معماری مدل زبانی، تعریف سازوکار fusion، ساخت pipeline آموزشی و آموزش end-to-end یک Graph-LLM مستقل شود. این دقیقاً همان بخشی از ظرفیت فناورانه است که با شمارش GPU یا حجم سرمایهگذاری بهتنهایی قابل سنجش نیست.
از منظر معماری نیز Haman صرفاً یک مدل فارسی ساختهشده بر بستر یک چارچوب آماده خارجی نیست؛ موتور Graph-LM و زنجیرهی معماریای که این مدل بر اساس آن ساخته و آموزش داده شده، در پروژه متنباز Rakhshai Graph-based NLP (RGN) توسط تیم ایرانی RakhshAI در شرکت آریا هامان مهر پارسه توسعه یافته است. نوآوری پروژه در اختراع اجزای شناختهشدهای مانند Transformer یا GNN بهتنهایی نیست، بلکه در طراحی و پیادهسازی یک معماری یکپارچه است که پردازش بومی متن فارسی را از PersianTokenizer آغاز میکند، از متن یک Multi-Relation Persian Graph میسازد، این ساختار را از طریق RakhshaiGraphEncoder با پشتیبانی از GCN، GraphSAGE، GAT و RGCN پردازش میکند و سپس با مکانیزم Adaptive Graph-Text Fusion بازنمایی گراف را در سطح توکن، جمله و زیرگراف با بازنمایی زبانی ترکیب میکند. در هستهی مدل، GraphCausalLM این اطلاعات تلفیقی را به یک decoder زبانی علّی با مؤلفههایی نظیر RoPE، SwiGLU و RMSNorm منتقل میکند و RGN علاوه بر آن، Low-Data Training Engine، Prompt-aware Graph Memory، سیستم آموزش و ارزیابی، checkpointing و ابزار ablation میان مدل گرافی و baseline بدون گراف را نیز در همان معماری فراهم کرده است. بنابراین آنچه در این پروژه اهمیت دارد تنها تولید وزنهای یک مدل ۱۲۵ میلیون پارامتری نیست، بلکه ساخت یک stack مستقل ایرانی برای طراحی، آموزش، ارزیابی و اجرای Graph-LLM است؛ stackی که تیم ایرانی کنترل معماری آن را از مرحلهی پردازش داده و ساخت گراف تا fusion، آموزش و تولید متن در اختیار دارد و برای ایجاد مدل مجبور به fine-tune کردن یا distillation از یک LLM خارجی نیست.
ما واقعیت محدودیت دسترسی ایران به زیرساختهای محاسباتی پیشرفته، شتابدهندههای روز و سرمایهگذاری در مقیاس کشورهای پیشرو منطقه را انکار نمیکنیم؛ این شکاف، بهویژه در توسعه مدلهای مرزی و بسیار بزرگ، یک محدودیت واقعی است. اما برخورداری از منابع محاسباتی بیشتر را نباید با توانایی بیشتر در خلق دانش و فناوری یکسان دانست. توان یک اکوسیستم هوش مصنوعی تنها با تعداد GPUهای در اختیار آن سنجیده نمیشود، بلکه در کیفیت الگوریتمها، طراحی معماریهای کارآمد، توسعه مدلهای تخصصی، بهینهسازی استفاده از منابع و حل مسائل بومی نیز نمود پیدا میکند. ایران ممکن است امروز در رقابت «مقیاس محاسباتی» در موقعیت ضعیفتری قرار داشته باشد، اما از این واقعیت نمیتوان نتیجه گرفت که پژوهشگران و مهندسان ایرانی قادر به خلق معماریهای نوآورانه، مدلهای کارآمد و فناوریهای مستقل—بهویژه برای زبان فارسی و نیازهای بومی—نیستند. محدودیت محاسباتی یک چالش مهندسی است، نه حکم نهایی درباره ظرفیت علمی یک کشور.
این نمونه را برای یادآوری جایگاه ایران مطرح میکنیم: ما صرفاً مصرفکننده یا متقاضی دسترسی نیستیم؛ سازنده فناوری هستیم. خرید زیرساخت اهمیت دارد، اما با تولید دانش فنی یکسان نیست. تحلیلی که اولی را برجسته کند و دومی را نسنجد، نمیتواند درباره آینده حکم قطعی بدهد.
برای زبان عربی هم پیشنهاد فناوری ایرانی داریم!
آمادهایم فناوری و معماری ایرانی خود را برای توسعه و ارزیابی مدلهای زبان عربی، در چارچوب همکاری مشترک، در اختیار شرکتها و پژوهشگران منطقه قرار دهیم ما این فن آوری را برای فرار از تحریم به کار نگرفته ایم برای کاربردی شدن فن آوری برای کارکرد های آن برای انسانیت به کار گرفته ایم .
ما در ایران، فقط یک مدل نساختهایم؛ زیرساخت تولید مدل ساختهایم. معماری ایرانی RGN، گراف چندرابطهای، ترکیب تطبیقی گراف و متن، حافظه گرافی و آموزش با داده محدود را در یک مسیر توسعه گرد آورده است. این زیرساخت میتواند با تطبیق برای صرف و نحو عربی، مبنای همکاری فناورانه با کشورهای منطقه قرار گیرد. پیشنهاد ما انتقال دانش طراحی و ساخت است؛ بخشی از توسعه هوش مصنوعی که معمولاً همراه با فاکتور خرید پردازنده تحویل داده نمیشود.
شاید در کنار قراردادهای خرید سختافزار، جایی هم برای همکاری در لایه مدل و معماری در نظر گرفته شود؛ بالاخره پس از تهیه پردازندهها، هنوز باید فناوریای ساخت که روی آنها اجرا شود.
ما دانش را به مرزبندیهای سیاسی محدود نمیکنیم. هیچکس حق اخلاقی ندارد فناوری را به ابزاری برای تحقیر ملتها، حذف پژوهشگران یا پیشبرد اغراض سیاسی تبدیل کند.
از The National انتظار داریم بهجای صدور حکم درباره آینده ایران، معیار و شواهد ارائه کند. ایران را میتوان نقد کرد؛ اما نمیتوان پیشداوری سیاسی را به نام ارزیابی علمی عرضه کرد.
آینده علمی ایران با اجازه یک رسانه آغاز نمیشود و با تصفیهحساب سیاسی پایان نمییابد. ما سهم خود را با مدل ایرانی، معماری ایرانی و دانش فنی برای خدمت به فرهنگ ایرانی میسازیم و تکنولوژی را محدود به هیچ کشور و در انحصار هیچ کشوری نمی دانیم .
یادداشت | شمشاد امیری خراسانی
رخشای | بخشی از جامعه فناوری ایران